


-
 Số 96-98 Hoàng Quốc Việt, Cầu Giấy, Hà Nội
-
 02437552050


Học lại dữ liệu của chính mình, các mô hình AI đang có nguy cơ sụp đổ?


Một nghiên cứu mới được công bố trên tạp chí Nature đã gióng lên hồi chuông cảnh báo rằng chất lượng đầu ra của các mô hình AI sẽ giảm đi nhanh chóng vì nội dung do AI tạo ra ngày càng tràn ngập Internet, trong khi dữ liệu miễn phí chủ yếu là đầu vào cho các mô hình AI...
Lâu dài, điều này có thể dẫn đến suy giảm hiệu suất của mô hình, cuối cùng dẫn đến việc tạo ra nội dung vô nghĩa, hiện tượng này được gọi là "Mô hình sụp đổ"...
Các nhà nghiên cứu từ Đại học Cambridge và Đại học Oxford đã tiến hành nghiên cứu chứng minh các thế hệ mô hình AI tiếp theo nếu được đào tạo trên dữ liệu tổng hợp từ AI sẽ tạo ra kết quả vô nghĩa.
Phương pháp nghiên cứu là đào tạo lặp lại nội dung của mô hình, kết quả là thông tin do AI tạo ra “làm ô nhiễm” bộ dữ liệu đào tạo, đầu ra của mô hình ngày càng trở nên không mạch lạc. Đến lần lặp thứ chín, mô hình đã tạo ra những từ vô nghĩa, chẳng hạn như đưa một chuyên luận về đuôi thỏ vào một bài viết về tháp nhà thờ Anh.
Những phát hiện của nghiên cứu đã tạo ra làn sóng lan tỏa trong cộng đồng AI. Julia Kempe, một nhà khoa học máy tính tại Đại học New York, mô tả đây là "một bài báo tuyệt vời" và "lời kêu gọi hành động" để các nhà nghiên cứu tìm ra giải pháp cho vấn đề.
Sự sụp đổ xảy ra vì mỗi lần lặp lại mô hình chỉ lấy mẫu từ dữ liệu đào tạo của nó, khuếch đại lỗi và sai lệch qua mỗi thế hệ. Các từ thông dụng trở nên phổ biến hơn, trong khi các thuật ngữ hiếm hơn ngày càng bị bỏ qua.
Hany Farid, một nhà khoa học máy tính tại Đại học California, ví hiện tượng này giống như cận huyết di truyền: "Nếu một loài cận huyết với con cháu của chính mình và không đa dạng hóa nhóm gen của chúng, điều đó có thể dẫn đến sự sụp đổ của loài".
“MÔ HÌNH SỤP ĐỔ” BAO GỒM HAI GIAI ĐOẠN
Mô hình sụp đổ về cơ bản được xác định bởi hai giai đoạn. Giai đoạn đầu tiên, một mô hình học hỏi dữ liệu từ một mô hình khác, vì vậy nếu mô hình ban đầu không hiểu đầy đủ các khía cạnh nội dung, đương nhiên chất lượng của mô hình tiếp theo cũng sẽ giảm đi do được đào tạo trên các đầu ra của mô hình trước đó.
Giai đoạn thứ hai là các mô hình sau sụp đổ. Đây là lúc các mô hình AI không còn hữu ích nữa do các mô hình trước đó đưa các lỗi của riêng chúng vào dữ liệu. Các lỗi có trong dữ liệu ban đầu được chuyển sang mô hình tiếp theo, mô hình này cũng thêm tập hợp lỗi của riêng mình và chuyển tiếp. Khi dữ liệu liên tục được tạo ra và tái chế, các mô hình bắt đầu hiểu sai thực tế và tạo ra nhiều lỗi hơn.
“Nếu có một số lỗi bên trong dữ liệu do mô hình một tạo ra, về cơ bản chúng sẽ lan truyền sang mô hình tiếp theo. Và cuối cùng, điều này dẫn đến việc mô hình về cơ bản nhận thức sai thực tế”, nhà nghiên cứu của thí nghiệm cho biết.
CÁC CÔNG TY AI SẼ CẦN LỌC DỮ LIỆU ĐẦU VÀO
Thí nghiệm chỉ ra mô hình có thể mắc phải ba lỗi phổ biến: lỗi kiến trúc, lỗi quy trình học và lỗi thống kê. Lỗi kiến trúc xảy ra khi cấu trúc của mô hình AI không phù hợp để nắm bắt tất cả các yếu tố phức tạp trong dữ liệu mà nó được cung cấp, dẫn đến sự không chính xác vì một số phần bị mô hình hiểu sai hoặc đơn giản hóa quá mức.
Còn lỗi quy trình học xảy ra khi các phương pháp được sử dụng để đào tạo các mô hình có thành kiến cố hữu, khiến mô hình mắc một số loại lỗi nhất định.
Cuối cùng, lỗi thống kê xuất hiện khi không có đủ dữ liệu để thể hiện chính xác những gì mô hình đang cố gắng học. Điều này có thể khiến mô hình tạo ra các dự đoán dựa trên thông tin không đầy đủ, dẫn đến lỗi.
Các mô hình AI phụ thuộc rất nhiều vào chất lượng dữ liệu mà chúng được đào tạo.
Tuy nhiên, khi chúng được đào tạo trên nội dung do AI tạo ra, dữ liệu này liên tục đưa lỗi vào hệ thống. Vì vậy, nghiên cứu cho rằng có khả năng các công ty sẽ phải dành thêm công sức để lọc dữ liệu. Và điều này có thể có nghĩa là quá trình nâng cấp các mô hình có thể chậm lại.
"Chúng ta cần phải cực kỳ cẩn thận trong việc đảm bảo rằng các mô hình của mình công bằng và không bỏ sót dữ liệu thiểu số bên trong chúng", một nhà nghiên cứu cho biết.
Để giải quyết vấn đề này, các tác giả của nghiên cứu đề xuất một số giải pháp tiềm năng. Bao gồm phát triển các phương pháp để đóng dấu nội dung do AI tạo ra, tạo động lực để con người tiếp tục tạo nội dung gốc và triển khai các quy trình lọc và quản lý chặt chẽ đối với dữ liệu đào tạo.


Tác nhân AI của OpenAI xâm nhập hệ thống y tế Australia: Ai chịu trách nhiệm?
Một tác nhân AI của OpenAI đã xâm nhập hệ thống y tế (Medicare) của Australia vào tháng 6, tiếp cận dữ liệu thống kê không công khai. Vụ việc đặt ra câu hỏi chưa có lời giải rõ ràng về trách nhiệm pháp lý khi một hệ thống AI tự chủ thực hiện hành vi xâm nhập…
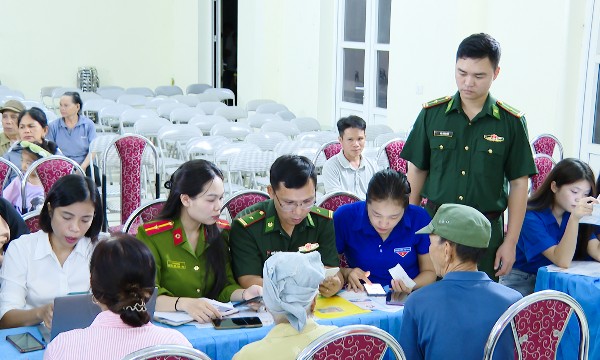
Công nghệ số theo chân người lính về bản làng biên giới
Từ chiếc điện thoại thông minh, người dân vùng biên Thanh Hóa có thể thực hiện nhiều thủ tục hành chính, sử dụng VNeID, tiếp cận thông tin pháp luật hay gửi tin báo đến lực lượng chức năng. Những tiện ích tưởng như xa lạ đang dần trở nên quen thuộc nhờ cách làm gần dân, trực tiếp hướng dẫn người dân của cán bộ, chiến sĩ Bộ đội Biên phòng...
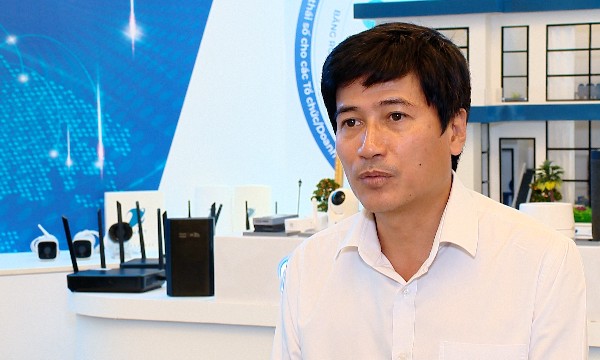
Biến không gian sống thành "nhà thông minh" chỉ với một thiết bị Gateway từ VNPT
Đón đầu kỷ nguyên Smart Home, hệ thống VNPT Mesh thế hệ mới không chỉ cung cấp kết nối Internet không gián đoạn mà còn tự động điều phối lưu lượng thông minh cho hàng chục thiết bị hoạt động cùng lúc, đem đến sự đột phá cho mỗi trải nghiệm trong ngôi nhà của bạn.
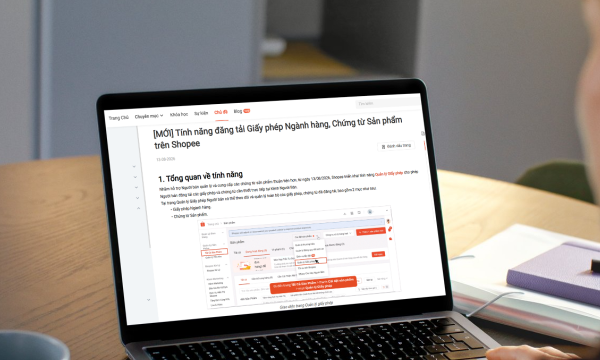
Minh bạch thông tin, nâng cao hiệu quả vận hành: Cơ sở tăng trưởng dài hạn trên thương mại điện tử
Nhà bán đang có thêm nhiều công cụ và chương trình hỗ trợ từ sàn thương mại điện tử để minh bạch thông tin sản phẩm, củng cố uy tín và nâng cao năng lực kinh doanh trực tuyến.
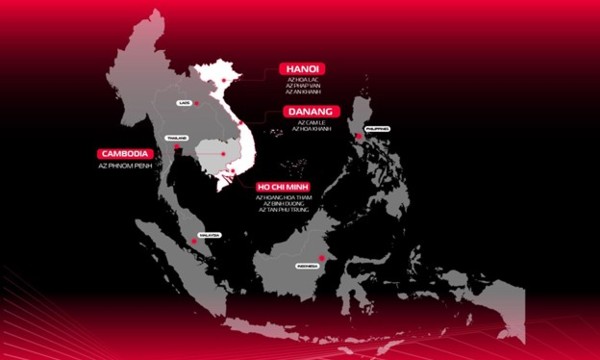
Viettel IDC: Nhà cung cấp Cloud chủ quyền duy nhất tại Đông Nam Á trong mạng lưới toàn cầu của Broadcom
Tại VMware Explore 2026 ở Las Vegas, Broadcom đã giới thiệu nhóm 57 nhà cung cấp dịch vụ đám mây chủ quyền (Sovereign Cloud) trên nền tảng VMware Cloud Foundation. Viettel IDC là đơn vị duy nhất tại Đông Nam Á có tên trong danh sách này, đánh dấu bước tiến mới của doanh nghiệp Việt Nam trên thị trường hạ tầng cloud khu vực.





Việt Nam chiếm 3,6% năng lực sản xuất thiết bị và linh kiện điện tử toàn cầu, đứng thứ sáu thế giới. Trung Quốc dẫn đầu với 58,8%, cao hơn tổng tỷ trọng của tất cả nền kinh tế còn lại trong bảng xếp hạng...







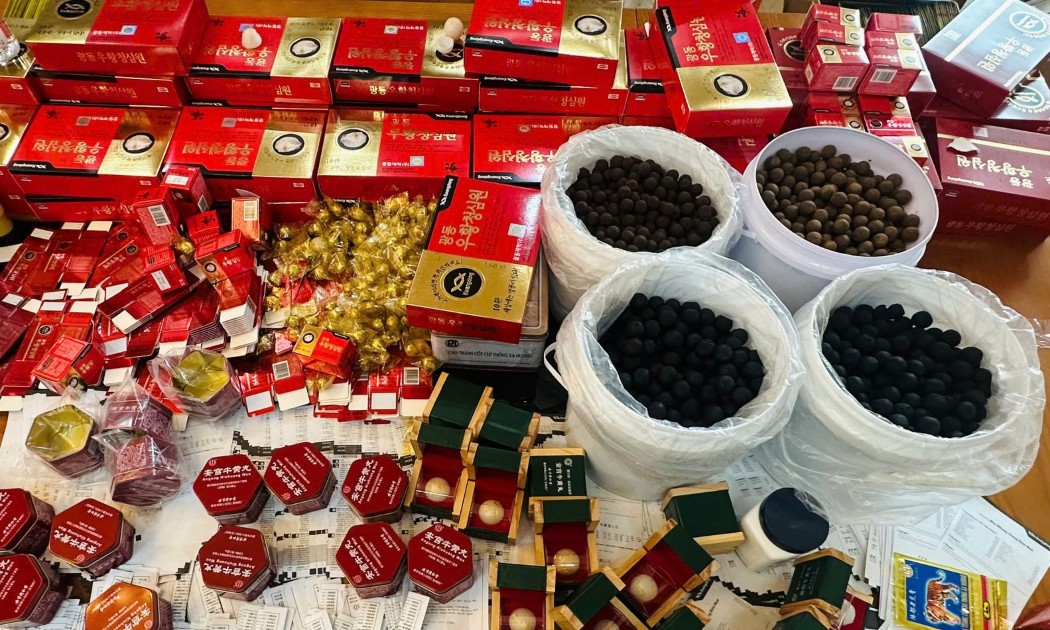
 Bột mì, hóa chất “hô biến” thành An Cung giả chống đột quỵ
Chỉ khoảng 105.000 đồng mỗi hộp, những sản phẩm An Cung giả được đưa qua nhiều tầng trung gian rồi bán đến tay người tiêu dùng với giá gần 3 triệu đồng. Đáng chú ý, các đối tượng sử dụng viên hoàn và nguyên liệu không rõ nguồn gốc để đóng gói, dán nhãn thành sản phẩm hàng ngoại.





81 năm Quốc khánh 2/9 (1945-2026)
Ngày 2/9/1945 đã mở ra bước ngoặt vĩ đại trong lịch sử dân tộc Việt Nam. Sự ra đời của nước Việt Nam Dân chủ Cộng hòa không chỉ khẳng định quyền độc lập, tự do và tự quyết về chính trị, mà còn trao...

Giá vàng trong nước và thế giới
VnEconomy cập nhật giá vàng trong nước & thế giới hôm nay: SJC, 9999, giá vàng USD/oz, biến động giá vàng tăng, giảm - phân tích, dự báo & dữ liệu lịch sử.

Kỷ niệm 35 năm thành lập Tạp chí Kinh tế Việt Nam (1991 - 2026)
Nhìn lại di sản và thành tựu của Thời báo Kinh tế Việt Nam - Tạp chí Kinh tế Việt Nam trong 35 năm qua, giá trị lớn nhất không chỉ đo bằng lượng thông tin phục vụ bạn đọc hàng ngày, hàng giờ, cũng...

VnEconomy Interactive
Interactive là một sản phẩm báo chí mới của VnEconomy vừa được ra mắt bạn đọc từ đầu tháng 3/2023 đã gây ấn tượng mạnh với độc giả bởi sự mới lạ, độc đáo. Đây cũng là sản phẩm độc quyền chỉ có trên...