


-
 Số 96-98 Hoàng Quốc Việt, Cầu Giấy, Hà Nội
-
 02437552050


Thiếu dữ liệu do con người tạo ra sẽ hạn chế tiến trình phát triển AI


Việc sử dụng những dữ liệu tổng hợp do máy tính tạo ra để đào tạo các mô hình trí tuệ nhân tạo (AI) có nguy cơ đi đến những kết quả vô nghĩa…
Một nghiên cứu mới từ Đại học Oxford đã nhấn mạnh những thách thức sắp xảy ra đối với các công nghệ mới nổi, đáng chú ý việc sử dụng dữ liệu do máy tính tạo ra để đào tạo các mô hình trí tuệ nhân tạo (AI) có nguy cơ khiến chúng tạo ra những kết quả vô nghĩa.
Các công ty AI hàng đầu bao gồm OpenAI và Microsoft đã thử nghiệm việc sử dụng dữ liệu tổng hợp - những thông tin do hệ thống AI tạo ra để sau đó đào tạo các mô hình ngôn ngữ lớn (LLM) khi những dữ liệu do con người tạo ra ngày một cạn kiệt.
Nghiên cứu được công bố trên tạp chí Nature ngày 24/7 cho thấy việc sử dụng dữ liệu như vậy có thể dẫn đến sự xuống cấp nhanh chóng của các mô hình AI. Một thử nghiệm sử dụng văn bản đầu vào về kiến trúc thời Trung cổ đã dẫn đến những thông tin về thỏ rừng sau chưa đầy 10 thế hệ đầu ra.
Bằng chứng này đã nhấn mạnh lý do vì sao các nhà phát triển AI lại vội vã mua rất nhiều những dữ liệu do con người tạo ra để đào tạo, đồng thời đặt ra câu hỏi rằng điều gì sẽ xảy ra khi những nguồn hữu hạn này cạn kiệt.
Ilia Shumailov, tác giả chính của nghiên cứu cho biết: “Dữ liệu tổng hợp thật tuyệt vời nếu chúng tôi có thể làm cho nó hoạt động được. Tuy nhiên điều chúng tôi đang nói là dữ liệu tổng hợp hiện tại có thể sai ở một số khía cạnh. Điều đáng ngạc nhiên nhất là chuyện này diễn ra nhanh đến mức nào".
Nghiên cứu tìm hiểu ra xu hướng sụp đổ của các mô hình AI theo thời gian do sự tích tụ và những sai lệch không thể tránh khỏi từ các thế hệ đào tạo kế tiếp. Tốc độ suy giảm có liên quan đến mức độ nghiêm trọng của những thiếu sót trong thiết kế mô hình, quá trình học tập và chất lượng dữ liệu được sử dụng. Các giai đoạn đầu của sự sụp đổ thường liên quan đến việc sai lệch từ những thông tin nhỏ, thiểu số và dần dần dẫn đến sai lệch trong đa số thông tin. Trong giai đoạn cuối của sự sụp đổ, tất cả các phần của dữ liệu có thể trở nên vô nghĩa.
Shumailov, người thực hiện công việc tại trường đại học Oxford cùng các đồng nghiệp từ Cambridge, Imperial College London, Edinburgh, cho biết: “Các mô hình mất đi tính hữu ích vì chúng tràn ngập tất cả các lỗi và quan niệm sai lầm do các thế hệ thông tin trước đưa ra".
Các nhà nghiên cứu nhận thấy vấn đề thường trở nên trầm trọng hơn do sử dụng dữ liệu tổng hợp được đào tạo dựa trên thông tin do các thế hệ trước tạo ra. Hầu như tất cả các mô hình ngôn ngữ được đào tạo mà họ kiểm tra đều bắt đầu tạo ra các cụm từ lặp lại.
Trong trường hợp thỏ rừng nêu trên, văn bản đầu vào đầu tiên khảo sát việc xây dựng tháp nhà thờ ở Anh trong thế kỷ 14 và 15. Ở giai đoạn đào tạo thứ nhất, đầu ra cung cấp thông tin về các vương cung thánh đường ở Rome và Buenos Aires. Thế hệ thứ năm chuyển sang dịch ngôn ngữ, trong khi thế hệ thứ chín liệt kê các loài thuộc họ Lagomorph với các màu đuôi khác nhau.
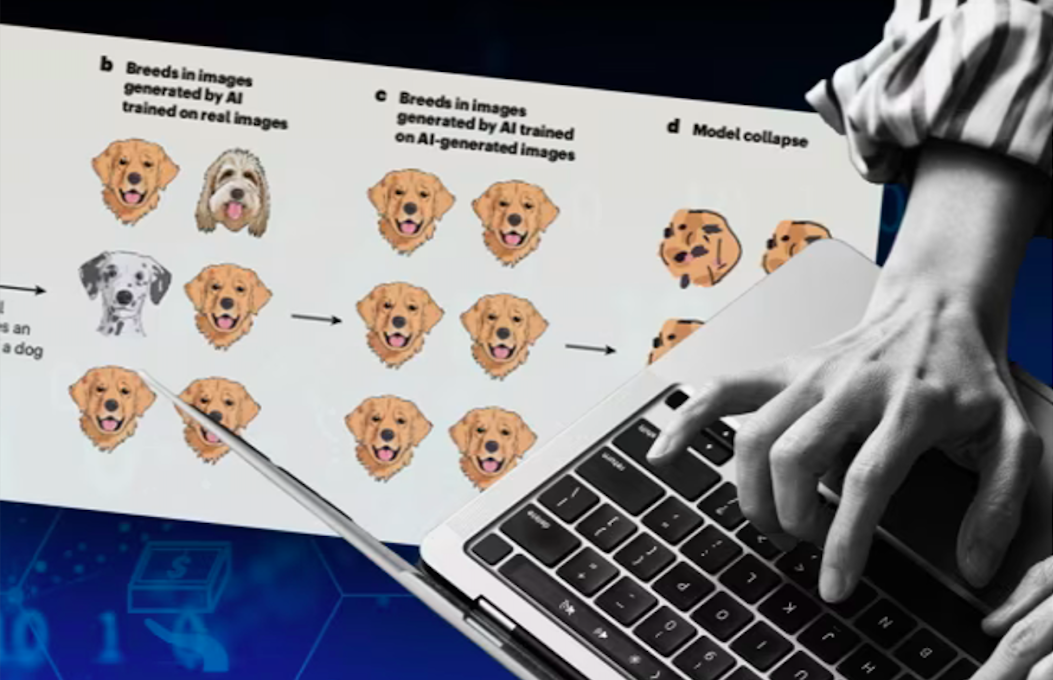
Một ví dụ khác là cách một mô hình AI được đào tạo dựa trên thông tin đầu ra của chính nó để xử lý một tập dữ liệu về hình ảnh giống chó, theo một bài viết trên tạp chí Nature của Emily Wenger thuộc Đại học Duke ở Mỹ.
Ban đầu, những loại phổ biến như chó tha mồi vàng sẽ chiếm ưu thế trong khi những giống ít phổ biến hơn như chó đốm biến mất. Cuối cùng, hình ảnh của những chú chó tha mồi vàng sẽ trở thành một mớ hỗn độn về mặt giải phẫu, với các bộ phận cơ thể ở sai vị trí.
Wenger cho biết, việc giảm thiểu vấn đề cho đến nay không hề đơn giản. Một kỹ thuật đã được các công ty công nghệ hàng đầu triển khai là nhúng hình mờ gắn cờ nội dung do AI tạo ra để loại trừ khỏi tập dữ liệu đào tạo. Khó khăn là điều này đòi hỏi sự phối hợp giữa các công ty công nghệ có thể không thực tế hoặc không khả thi về mặt thương mại.
Đọc bài theo từ khoá

VN-Index giảm nhẹ, nhà đầu tư thận trọng chờ tín hiệu mới

Chủ tịch Quốc hội Trần Thanh Mẫn dự Phiên họp Ban Chấp hành AIPA
Tổng Bí thư, Chủ tịch nước Tô Lâm đề nghị các tập đoàn Trung Quốc đẩy mạnh đầu tư, phát triển công nghệ tại Việt Nam
Việt Nam đề nghị tăng cường hợp tác với Trung Quốc về AI, bán dẫn và công nghệ cao
Đà Nẵng đẩy mạnh phát triển công nghiệp công nghệ số bằng các chính sách cụ thể
Công tác tuyên truyền, phổ biến văn bản pháp luật về công nghiệp công nghệ số ở Đà Nẵng không chỉ là cơ hội để đối chiếu, kiểm chứng chính sách với nhu cầu thực tế mà còn nhằm thúc đẩy phát triển công nghiệp công nghệ số, vi mạch bán dẫn và trí tuệ nhân tạo tại địa phương...
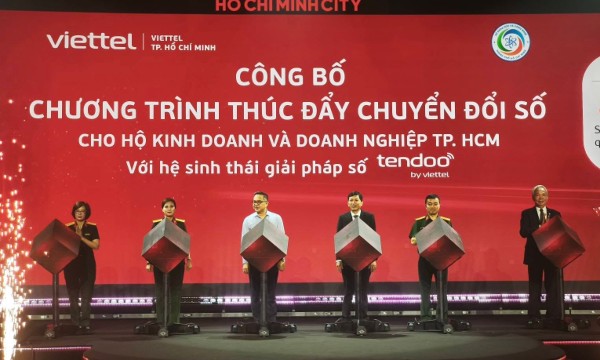
TP. Hồ Chí Minh đẩy mạnh chuyển đổi số, hỗ trợ hộ kinh doanh và doanh nghiệp lên tới 370 tỷ đồng
Tổng Công ty Viễn thông Viettel (Viettel Telecom) và Sở Khoa học và Công nghệ TP. Hồ Chí Minh công bố chương trình hỗ trợ lên tới 370 tỷ đồng, nhằm thúc đẩy kinh tế số và hỗ trợ chuyển đổi số cho hộ kinh doanh, doanh nghiệp nhỏ và vừa…
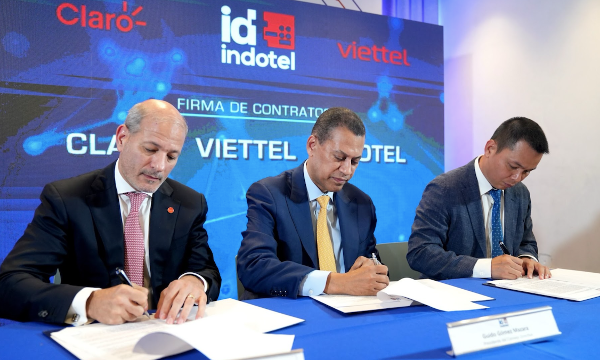
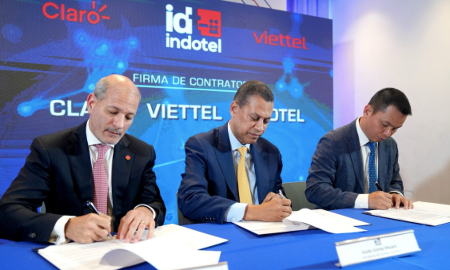
Viettel chính thức được cấp phép kinh doanh viễn thông tại Dominica
Ngày 16/11/2026, tại trụ sở Viện Viễn thông Cộng hòa Dominica (INDOTEL), Viettel Dominicana S.A.S. đã chính thức ký kết hợp đồng nhượng quyền viễn thông với INDOTEL...
Khơi dậy “mỏ vàng tài nguyên số” ở xã miền cao Lâm Bình
Trước đây, nguồn thu chủ yếu đến từ các hoạt động sản xuất, kinh doanh và dịch vụ truyền thống thì hiện nay, hoạt động sáng tạo nội dung, thương mại điện tử và kinh doanh trên các nền tảng số đang từng bước hình thành những nguồn thu mới, góp phần đa dạng hóa hoạt động kinh tế và mở rộng nguồn thu ngân sách nhà nước. Xã Lâm Bình, Tuyên Quang, đang trở thành một điển hình vươn lên mạnh mẽ nhờ kinh tế số và tài nguyên số...
Bê bối Nvidia phơi bày thế khó của Trung Quốc trong cuộc đua AI với Mỹ
Vụ việc liên quan đến Jensen Huang, nhà đồng sáng lập và cựu CEO Nvidia, làm gia tăng sức ép quanh xuất khẩu chip AI sang Trung Quốc, đồng thời phơi bày thế khó của Bắc Kinh giữa nhu cầu công nghệ Mỹ và tham vọng tự chủ bán dẫn…





Lãnh đạo Bộ Xây dựng xác nhận, Luật Nhà ở (sửa đổi) được chỉnh lý, bổ sung nhằm bảo đảm người thu nhập thấp có khả năng tiếp cận được nhà ở thông qua việc thể chế hóa rõ nhóm các đối tượng được hưởng chính sách về nhà ở xã hội, nhà ở cho thuê và nhà lưu trú công nhân; quy định cụ thể các điều kiện về nhà ở, thu nhập và thứ tự ưu tiên xét duyệt đối với từng loại hình chính sách.






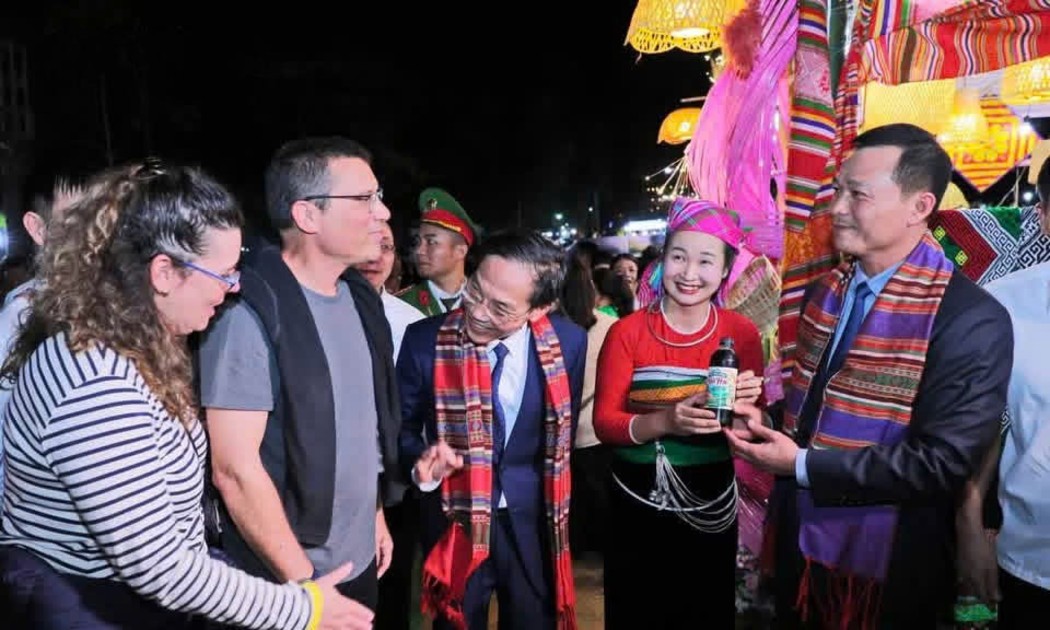
 Pù Luông – Nơi bản sắc đánh thức tiềm năng, du lịch xanh định vị điểm đến
Giữa đại ngàn xứ Thanh, Pù Luông hấp dẫn du khách bởi những thung lũng xanh, ruộng bậc thang uốn lượn, bản làng nép mình bên sườn núi và đời sống văn hóa đặc sắc của đồng bào các dân tộc. Không chỉ sở hữu lợi thế về cảnh quan, nơi đây còn có sức hút từ những giá trị văn hóa bản địa được gìn giữ qua nhiều thế hệ. Khai thác tiềm năng gắn với bảo tồn bản sắc, phát triển du lịch xanh và tạo sinh kế cho người dân đang mở ra hướng đi bền vững cho điểm đến này.



Kỳ họp thứ 2, Quốc hội khoá XVI
Kỳ họp thứ 2, Quốc hội khoá XVI dự kiến kéo dài 28 ngày bắt đầu từ 17/10/2026. Kỳ họp với khối lượng công việc lớn, dự kiến xem xét, thông qua 43 luật, nghị quyết quy phạm pháp luật và quyết định...

Việt Nam: Khát vọng quốc gia biển mạnh
Yêu cầu cốt lõi mà Nghị quyết 20 đặt ra là phải biến nước ta từ một quốc gia có biển thành một quốc gia biển mạnh, với kinh tế biển phát triển hiện đại, có năng lực cạnh tranh cao, đồng thời giữ vững...

Kỷ niệm 35 năm thành lập Tạp chí Kinh tế Việt Nam (1991 - 2026)
Nhìn lại di sản và thành tựu của Thời báo Kinh tế Việt Nam - Tạp chí Kinh tế Việt Nam trong 35 năm qua, giá trị lớn nhất không chỉ đo bằng lượng thông tin phục vụ bạn đọc hàng ngày, hàng giờ, cũng...

VnEconomy Interactive
Interactive là một sản phẩm báo chí mới của VnEconomy vừa được ra mắt bạn đọc từ đầu tháng 3/2023 đã gây ấn tượng mạnh với độc giả bởi sự mới lạ, độc đáo. Đây cũng là sản phẩm độc quyền chỉ có trên...